Slop OCR 指南
Slop OCR 入門
Slop OCR 可辨識圖片與 PDF 中的文字。辨識模型在您的瀏覽器中執行,因此您的檔案絕不會上傳。
只需取得一次模型
首次使用時,頁面會顯示「此工具需要模型」。模型為 PP-OCRv4(約 15 MB)。在您要求之前,不會下載任何內容。
- 點選「取得更多…」。
- 閱讀授權條款,然後點選「下載」。
- 完成後,檔案區域就會出現。模型會保留在您的瀏覽器中,下次可直接使用。
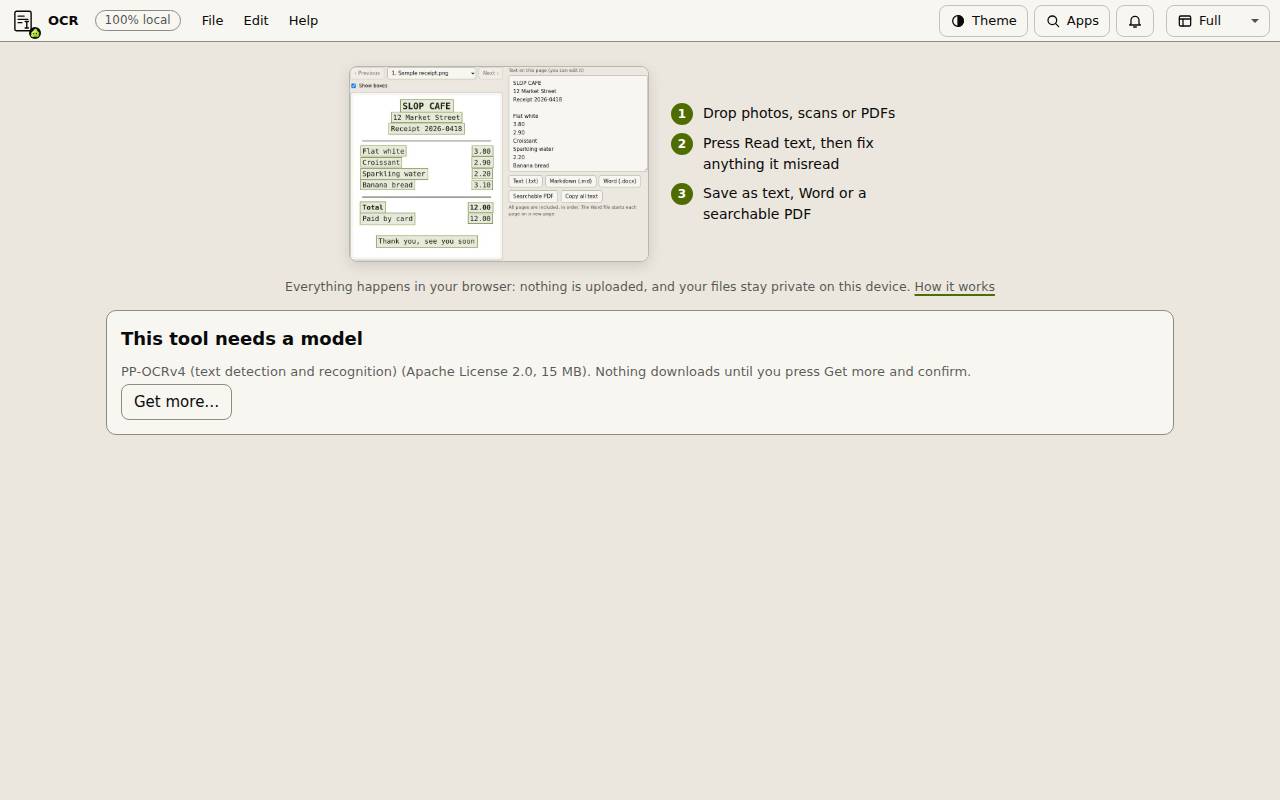
辨識文字
- 將圖片或 PDF 拖到方框上,或點選「選擇檔案」。可一次加入多個檔案。若想試用,請點選「試試範例收據」。
- 點選「辨識文字」。進度列會顯示完成的程度。
- 每一頁都會顯示其找到的文字行周圍的框線。取消勾選「顯示框線」即可隱藏。
- 使用「上一個」、「下一個」或頁面清單,即可在頁面與檔案之間移動。
檢查、校正與儲存
您目前所在頁面的文字會顯示在右側的方框中。儲存前可在那裡直接編輯。
「文字 (.txt)」、「Markdown(.md)」與「Word (.docx)」會依順序儲存所有頁面;Word 檔案會讓每一頁各自從新的一頁開始。「可搜尋的 PDF」會保留每一頁的圖片,並在其上放置不可見的文字,讓您可以搜尋與選取。「複製全部文字」會將文字放入剪貼簿。
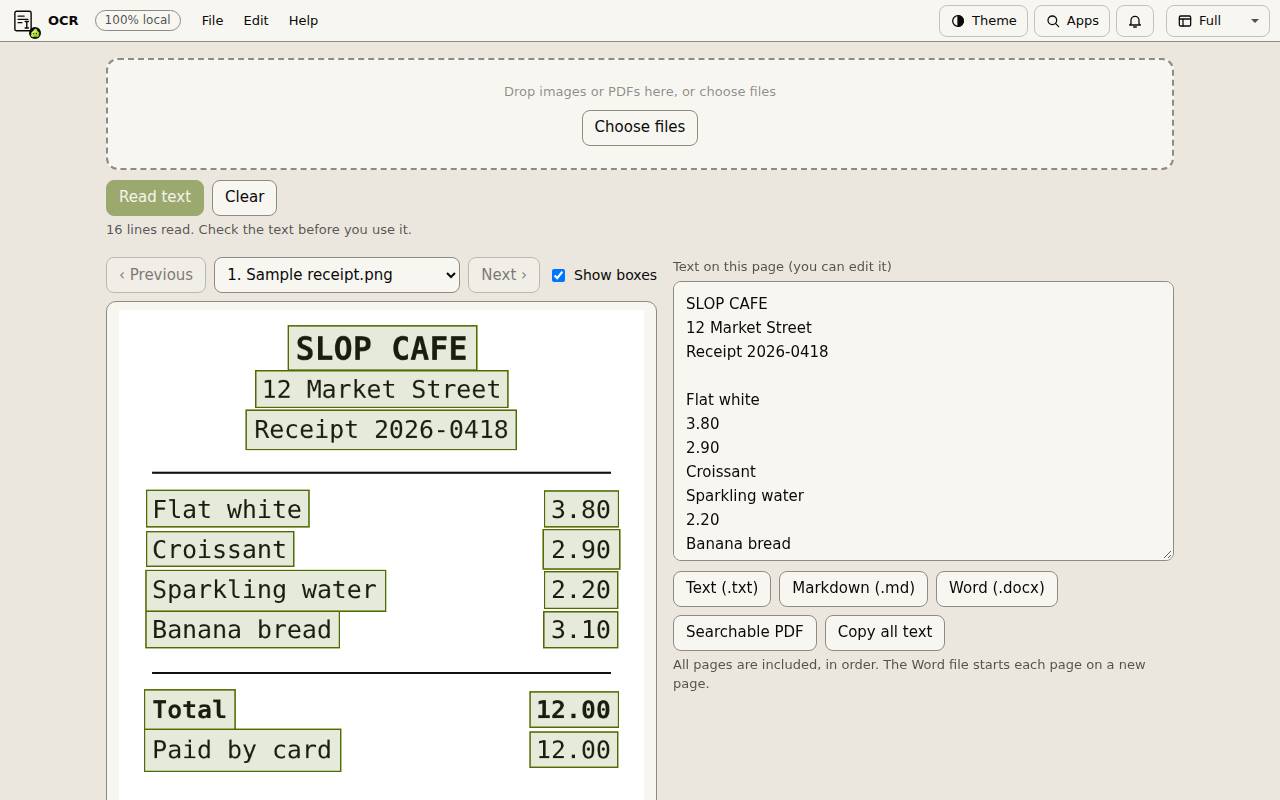
提示: 使用文字前請先檢查辨識結果。請在「語言與模型」下選擇文字的語言(85 種語言,每種書寫系統一個模型),且只會辨識橫向的文字行。文字行右側的價格可能會變成獨立的一行。