Anleitung zu Slop OCR
Erste Schritte mit Slop OCR
Slop OCR liest den Text in Bildern und PDFs. Das Lesemodell läuft in Ihrem Browser, daher werden Ihre Dateien nie hochgeladen.
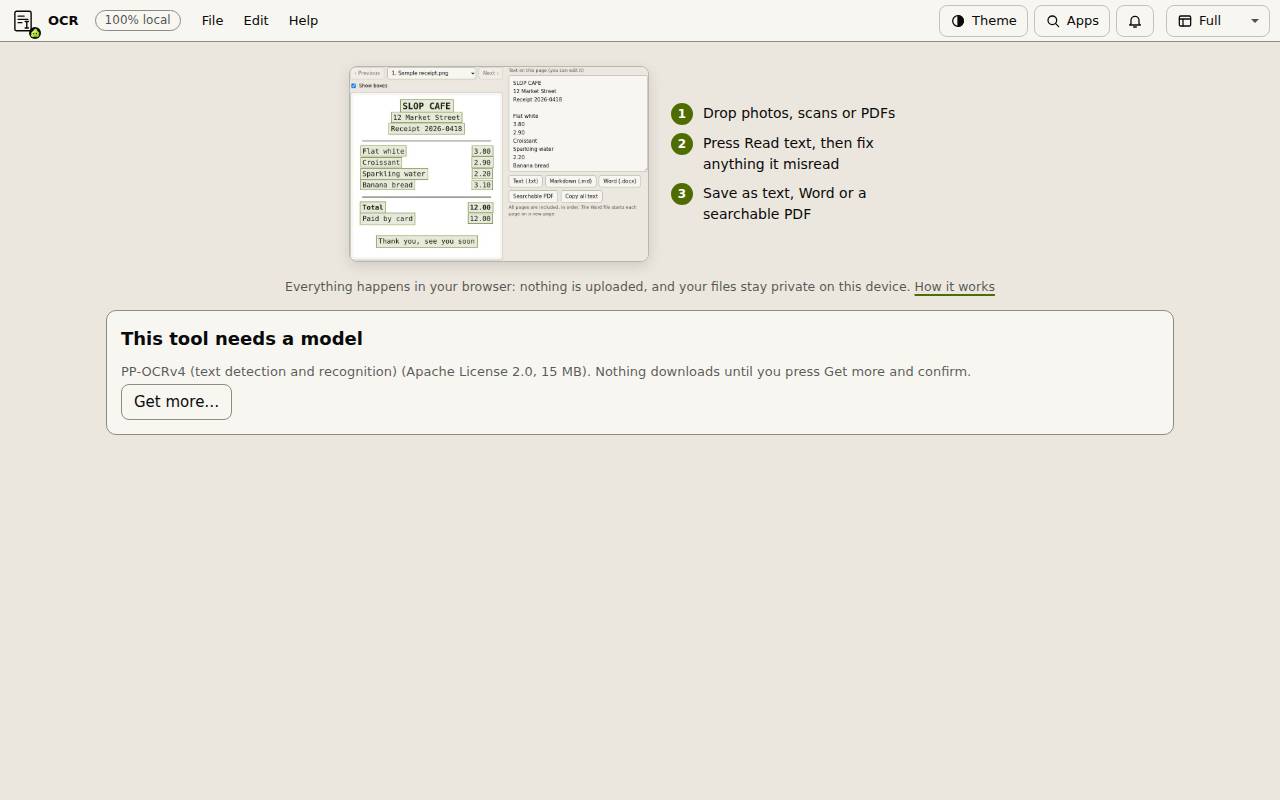
Das Modell einmal laden
Beim ersten Mal sagt die Seite: Dieses Werkzeug braucht ein Modell. Das Modell ist PP-OCRv4 (etwa 15 MB). Es wird erst geladen, wenn Sie es verlangen.
- „Weitere laden…“ klicken.
- Die Lizenz lesen und auf „Herunterladen“ klicken.
- Wenn es fertig ist, erscheint der Dateibereich. Das Modell bleibt beim nächsten Mal in Ihrem Browser.
Den Text lesen
- Bilder oder PDFs auf das Feld ziehen oder „Dateien auswählen“ klicken. Sie können mehrere auf einmal hinzufügen. Zum Ausprobieren auf „Mit einem Beispielbeleg ausprobieren“ klicken.
- „Text erkennen“ klicken. Ein Fortschrittsbalken zeigt, wie weit es ist.
- Jede Seite erscheint mit Rahmen um die erkannten Zeilen. „Rahmen anzeigen“ abwählen, um sie zu verbergen.
- Mit Zurück, Weiter oder der Seitenliste wechseln Sie zwischen Seiten und Dateien.
Prüfen, korrigieren und speichern
Der Text der aktuellen Seite steht im Feld rechts. Sie können ihn dort korrigieren, bevor Sie speichern.
Text (.txt), Markdown (.md) und Word (.docx) speichern alle Seiten in Reihenfolge; die Word-Datei beginnt jede Seite auf einer neuen Seite. Durchsuchbares PDF behält das Bild jeder Seite und legt unsichtbaren Text darüber, sodass Sie ihn durchsuchen und markieren können. „Gesamten Text kopieren“ legt ihn in die Zwischenablage.
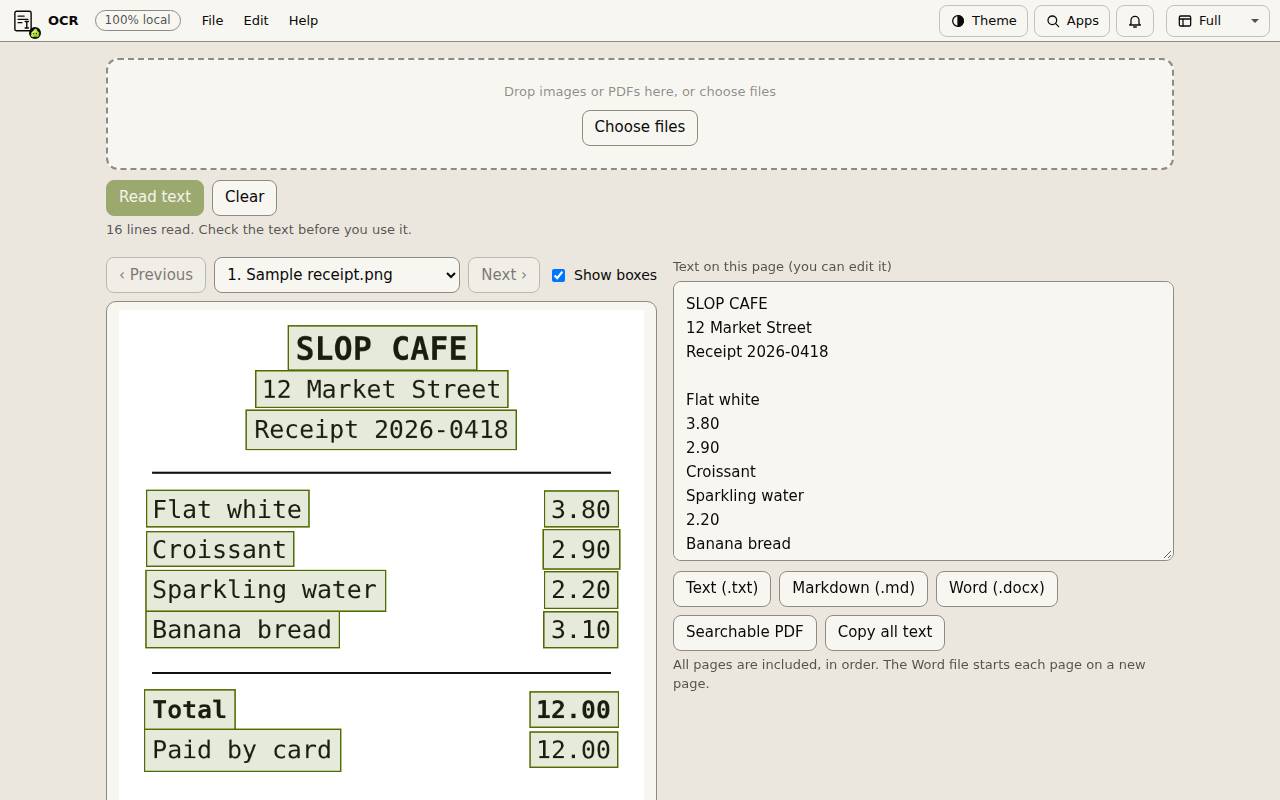
Tipp: Prüfen Sie den Text, bevor Sie ihn verwenden. Wählen Sie die Sprache des Textes unter Sprache und Modell (85 Sprachen, ein Modell je Schrift), und es werden nur waagerechte Zeilen gelesen. Preise rechts neben einer Zeile können in eigenen Zeilen landen.