Slop OCR · 免费,在浏览器中完成
将扫描 PDF 转为可搜索的 PDF
扫描件只是页面的图片,因此无法搜索或复制其中的文字。Slop OCR 会识别每一页,并保存为一个 PDF,文字隐藏在每张图片之下。
操作方法
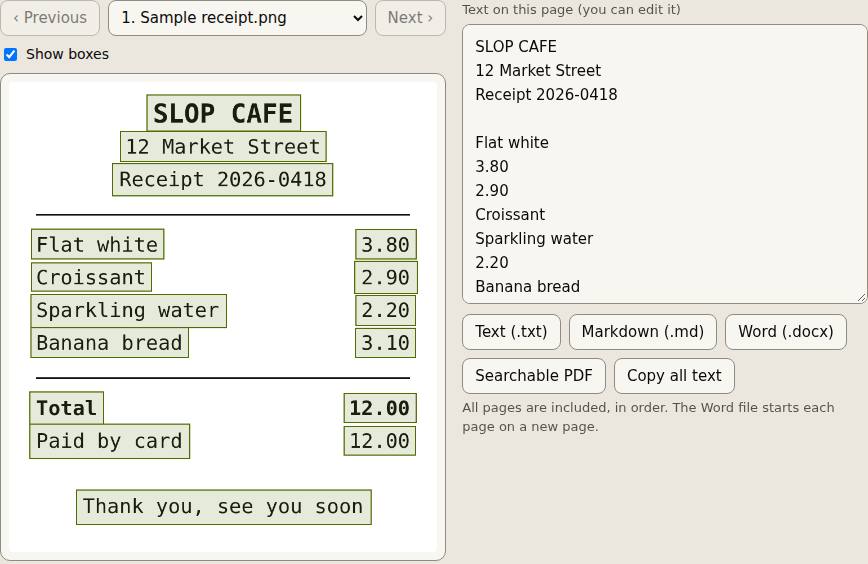
- 将扫描 PDF 拖到页面上。所有页面都会列出。
- 首次使用时,选择“获取更多”并接受许可证,即可下载 OCR 模型。
- 选择“识别文字”,并等待每一页以 200 dpi 完成识别。
- 使用“上一页”和“下一页”检查并修正每页的文字。
- 选择“可搜索的 PDF”,下载新文件。
你的文件保留在本设备上:Slop OCR 在浏览器中运行,不上传、无需账户,也没有水印。
常见问题
PDF 的外观会改变吗?
不会。每页的图片都会保留,文字位于其上方的隐形文字层中,搜索和选择都能找到它。
哪些字符会进入文字层?
PDF 的标准字体只能绘制拉丁字母,因此英文文字效果最好。它无法绘制的字符(例如中文)不会进入文字层,但图片中仍会显示。
能改为获取 Word 文件吗?
可以。选择“另存为 Word(.docx)”,即可获得文字内容,每页都从新的一页开始;也可以保存为纯文本或 Markdown。
扫描件会被上传吗?
不会。每一页都在你的浏览器中、使用存储在你设备上的模型进行识别。
Slop OCR 的更多用法
相关应用
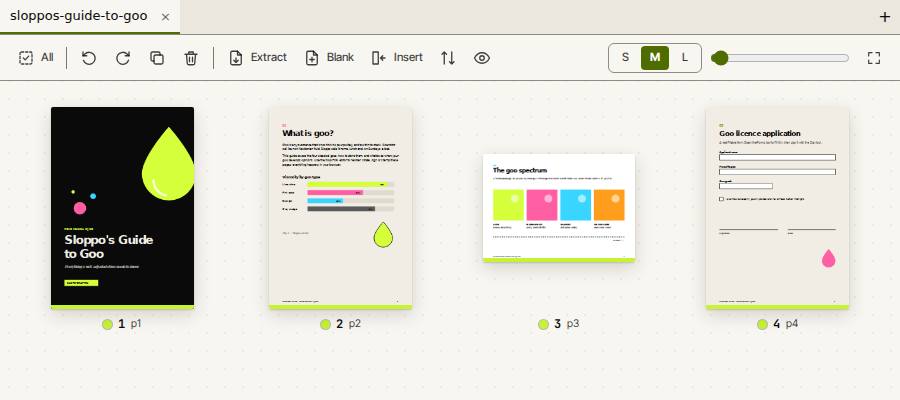 Slop PDF
已上线
整理、编辑和签署 PDF。不上传任何内容。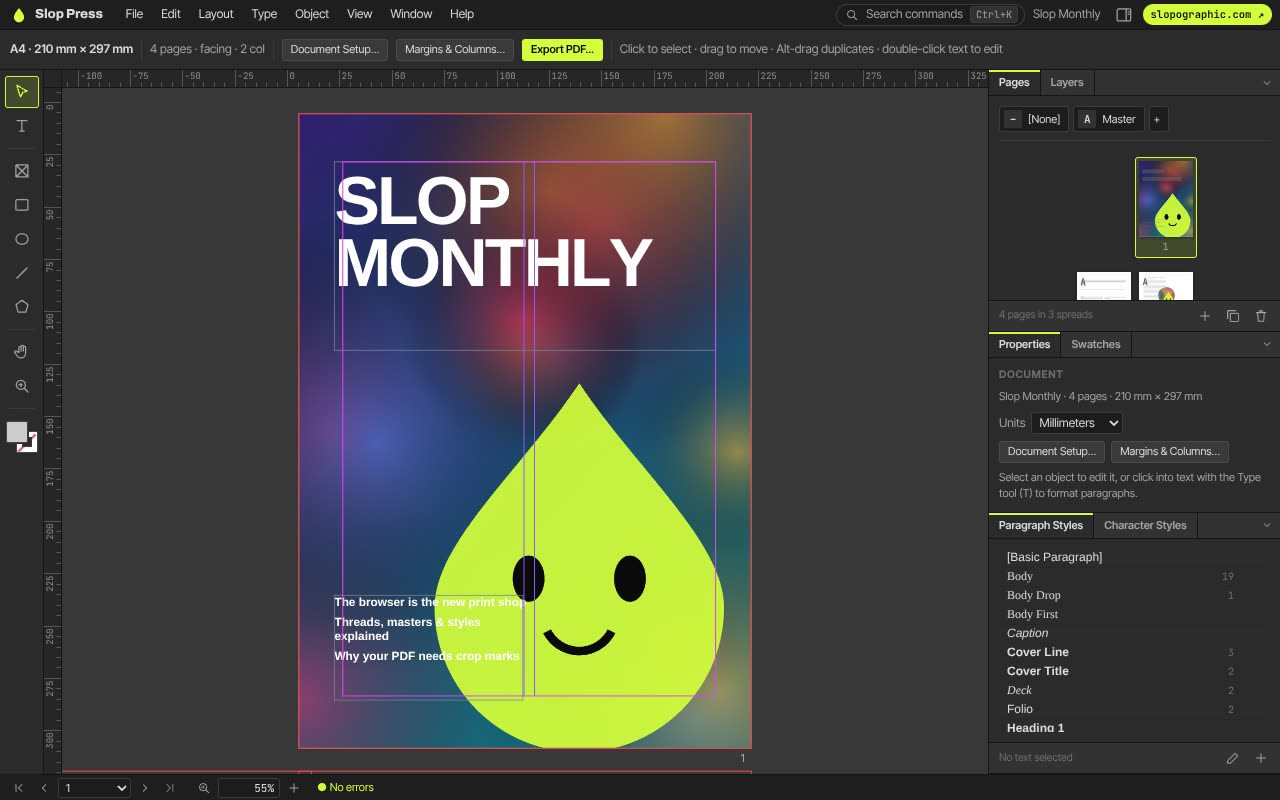 Slop Press
测试版
为浏览器重新打造的 InDesign。- Slop Compare
测试版
比较两段文本、文件、PDF 或图片,查看每一处变化。不上传任何内容。