Slop OCR 指南
Slop OCR 入门
Slop OCR 可读取图片和 PDF 中的文字。识别模型在你的浏览器中运行,因此你的文件绝不会上传。
只需获取一次模型
首次使用时,页面会显示“此工具需要一个模型”。模型为 PP-OCRv4(约 15 MB)。在你请求之前,不会下载任何内容。
- 点击“获取更多…”。
- 阅读许可协议,然后点击“下载”。
- 下载完成后,文件区域会出现。模型会保留在你的浏览器中,下次无需再下载。
读取文字
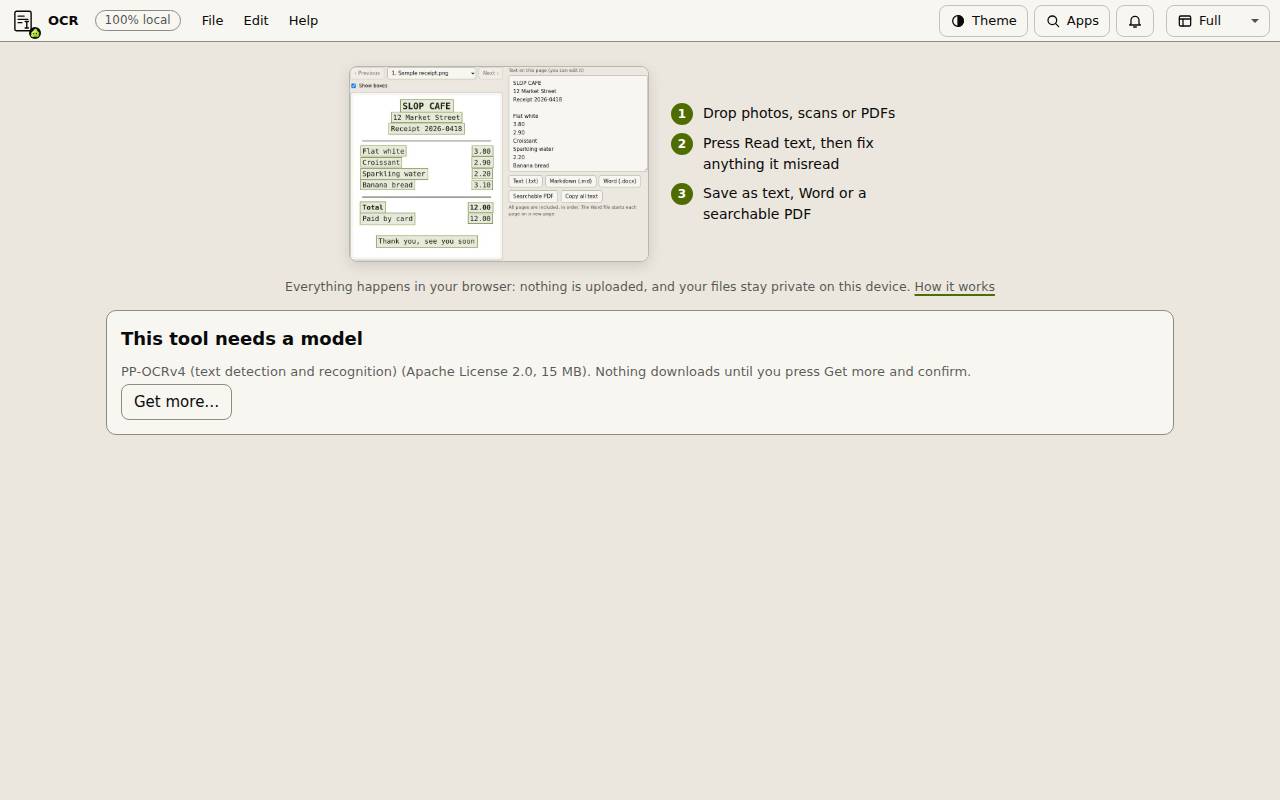
- 把图片或 PDF 拖到方框中,或点击“选择文件”。可以一次添加多个。想试一试,可点击“用示例收据试用”。
- 点击“读取文字”。进度条会显示完成的进度。
- 每一页都会显示,并在其识别到的行周围画出方框。取消勾选“显示方框”即可隐藏它们。
- 使用“上一个”“下一个”或页面列表,在各页和各文件之间切换。
检查、修正和保存
你当前所在页面的文字显示在右侧的方框中。保存之前可以在那里直接编辑。
“文本(.txt)”“Markdown(.md)”和“Word(.docx)”会按顺序保存所有页面;Word 文件中每页都从新的一页开始。“可搜索的 PDF”会保留每页的图片,并在其上放置不可见的文字,因此你可以搜索和选中文字。“复制全部文字”会将其放入剪贴板。
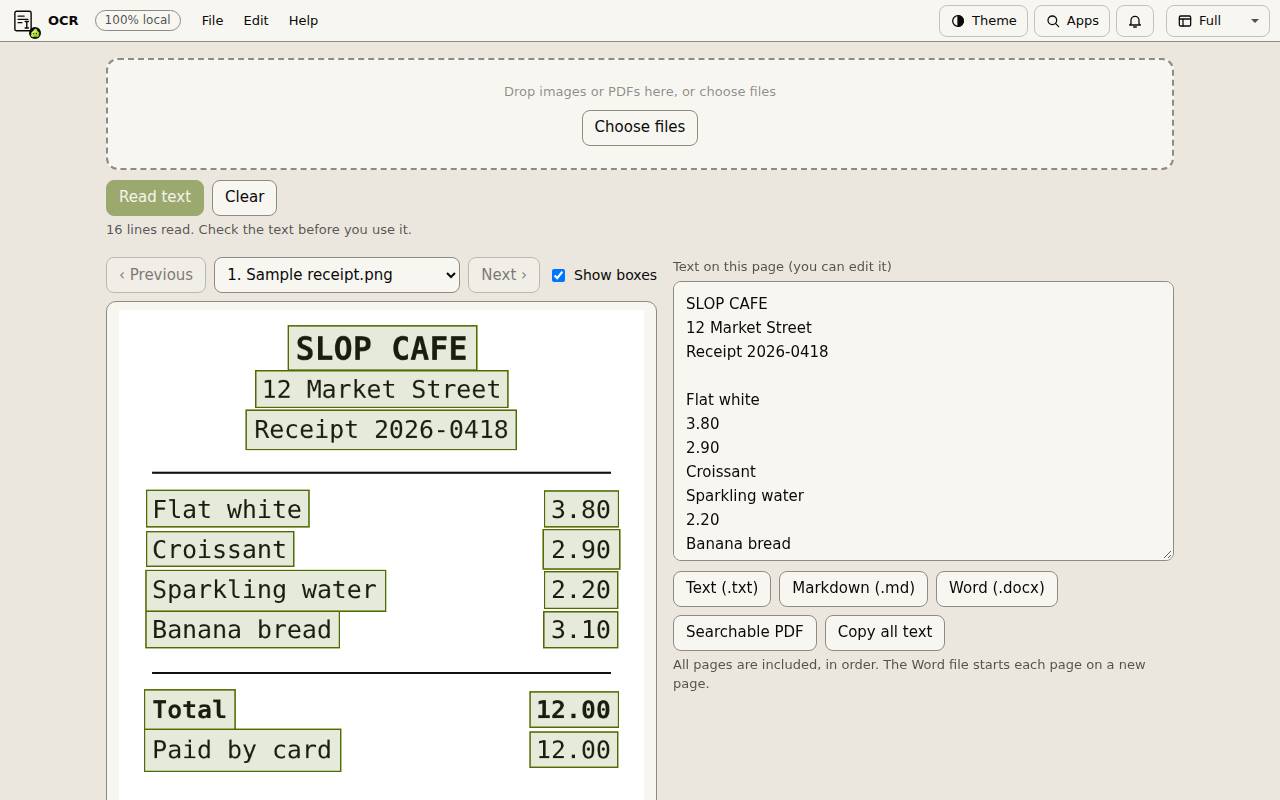
提示: 使用文字前请先核对。在“语言和模型”下选择文字的语言(85 种语言,每种书写系统一个模型),而且只识别水平排列的行。行末右侧的价格可能会被单独放到另一行。