Slop OCR · 免费,在浏览器中完成
复制图片中的文字
拖入收据照片、截图或扫描页面,Slop OCR 会在你的设备上识别其中的文字行。检查结果,编辑后即可复制或保存。
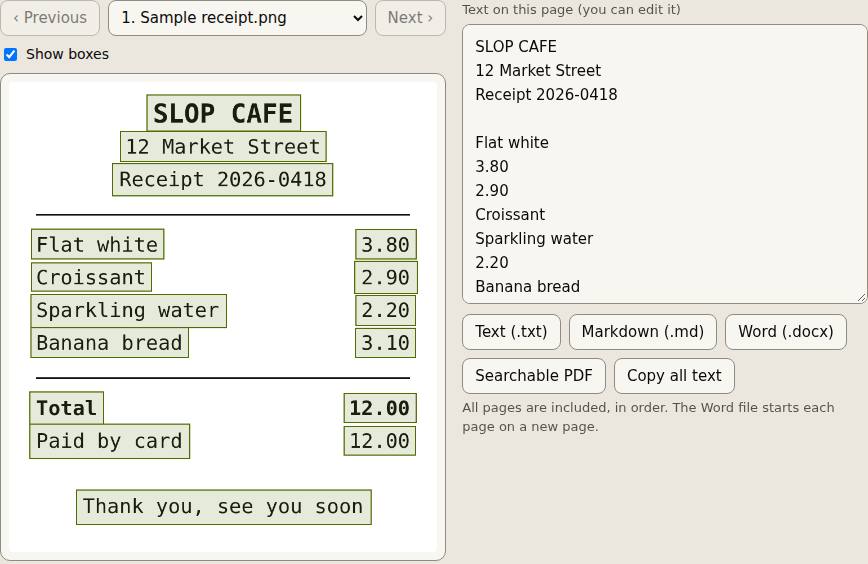
操作方法
- 将图片拖到页面上,或选择文件。多张图片会按单独的页面识别。
- 首次使用时,选择“获取更多”并接受许可证,即可将 OCR 模型下载到此浏览器中。
- 选择“识别文字”。系统会用方框标出图片中找到的每一行文字。
- 如有需要,请在图片旁边的文本框中修正文字。
- 选择“复制全部文字”,或保存为“文本(.txt)”、Markdown(.md)或 Word(.docx)。
你的文件保留在本设备上:Slop OCR 在浏览器中运行,不上传、无需账户,也没有水印。
常见问题
能识别哪些语言?
支持 85 种语言,每种文字系统使用一个模型:瑞典语、德语、法语、波兰语以及约 50 种其他带重音符号的拉丁字母语言;俄语和其他西里尔字母语言;阿拉伯语、波斯语和乌尔都语;印地语;中文、日语和韩语;希腊语、泰语、泰米尔语和泰卢固语。在“语言和模型”中选择语言;若不选择,则会优先识别中文和英文,并建议合适的模型。
图片会被上传吗?
不会。模型只需下载一次,并在你的浏览器中运行,因此图片在你的设备上识别。
为什么有些文字缺失或识别错误?
只能识别水平排列的文字行,模糊、倾斜或非常小的文字更难识别。请将照片摆正并裁剪,使用前务必检查结果。
能一次识别多张图片吗?
可以。添加多张图片后,“识别文字”会依次处理;保存的文件包含每一页。
Slop OCR 的更多用法
相关应用
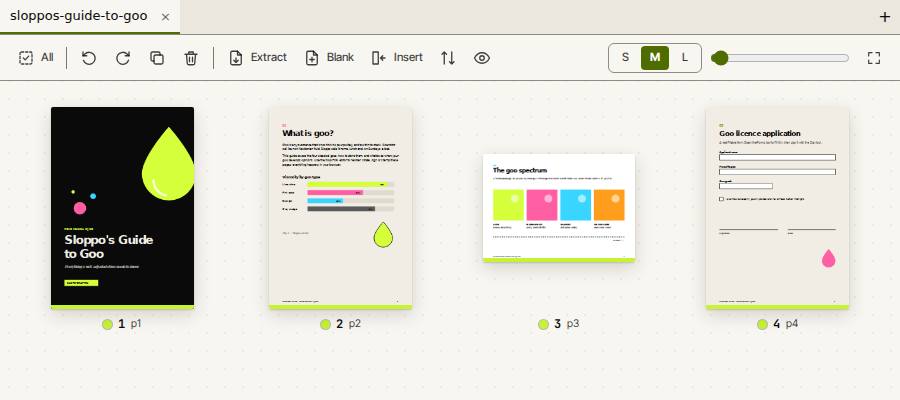 Slop PDF
已上线
整理、编辑和签署 PDF。不上传任何内容。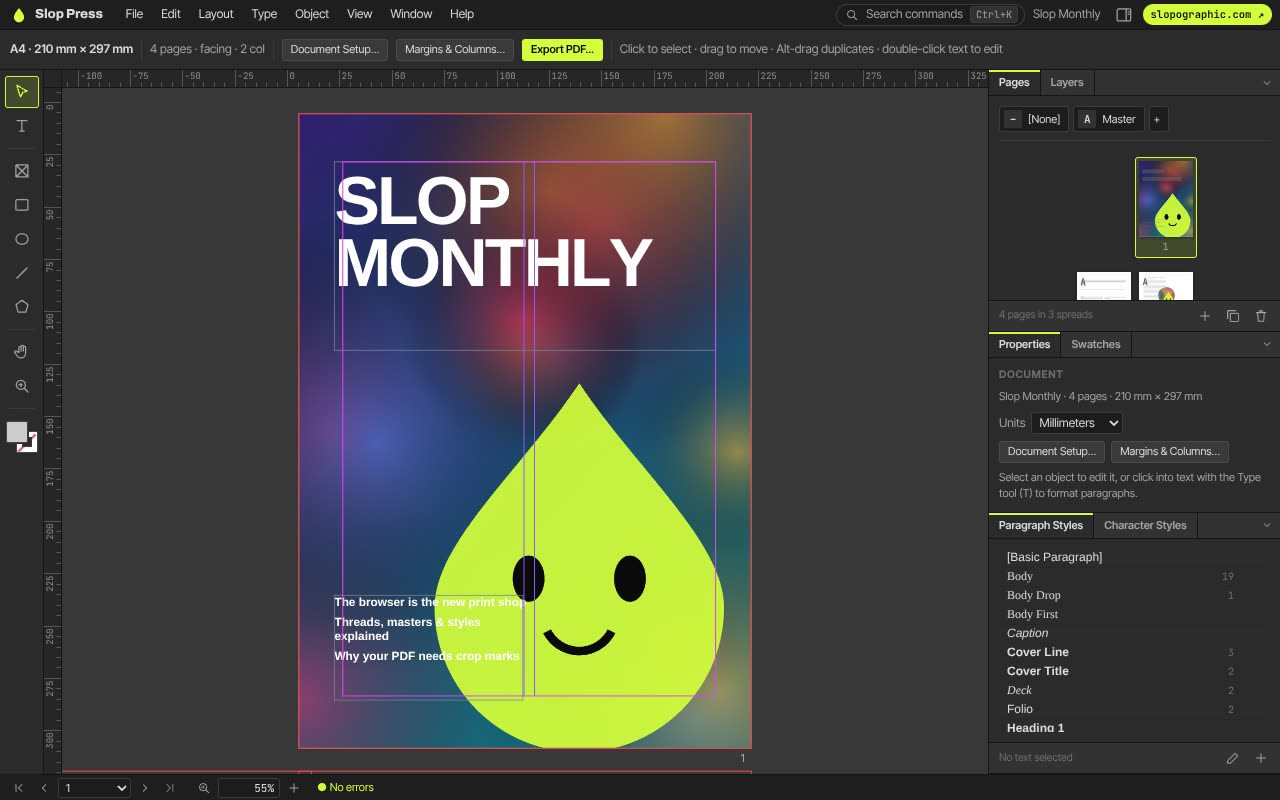 Slop Press
测试版
为浏览器重新打造的 InDesign。- Slop Compare
测试版
比较两段文本、文件、PDF 或图片,查看每一处变化。不上传任何内容。