Slop OCR · безкоштовно, у вашому браузері
Перетворіть відсканований PDF на PDF з пошуком
Скан — це лише зображення сторінок, тож у ньому не можна шукати чи копіювати. Slop OCR читає кожну сторінку й зберігає PDF із текстом, прихованим під кожним зображенням.
Зробити PDF доступним для пошуку
Як це зробити
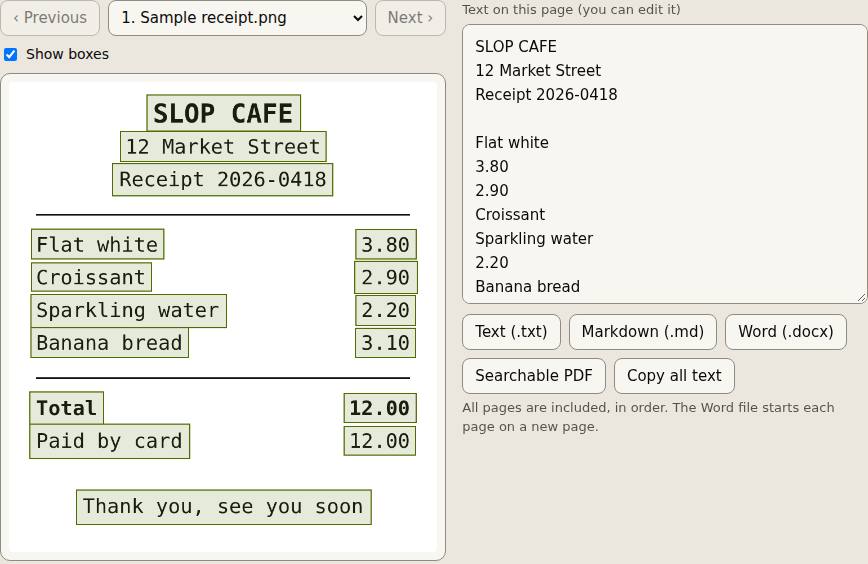
- Перетягніть відсканований PDF на сторінку. Кожна сторінка перелічується.
- Вперше натисніть «Отримати більше…» і погодьтеся з ліцензією, щоб завантажити модель OCR.
- Виберіть «Розпізнати текст» і дочекайтеся, поки кожну сторінку буде прочитано з роздільною здатністю 200 dpi.
- Перевірте й виправте текст кожної сторінки кнопками «Попередня» і «Наступна».
- Виберіть «PDF з пошуком тексту», щоб завантажити новий файл.
Ваші файли лишаються на цьому пристрої: Slop OCR працює у вашому браузері, без вивантаження, облікового запису й водяного знака.
Питання
Чи виглядає PDF так само?
Так. Зображення кожної сторінки зберігається, а текст лежить у невидимому шарі поверх нього, де його знаходять пошук і виділення.
Які символи потрапляють до текстового шару?
Стандартний шрифт PDF малює лише латинські літери, тож найкраще працює англійський текст. Символи, які він не може намалювати, як китайські, пропускаються в шарі; зображення все одно їх показує.
Чи можна натомість отримати файл Word?
Так. «Word (.docx)» зберігає текст, кожна сторінка починається з нової, або як простий текст чи Markdown.
Чи вивантажується скан?
Ні. Кожна сторінка читається у вашому браузері моделлю, збереженою на вашому пристрої.
Більше з Slop OCR
Пов’язані застосунки
 Slop PDF
Працює
Упорядковуйте, редагуйте й підписуйте PDF. Нічого не вивантажується. Slop Press
Бета
InDesign, створений заново для браузера.- Slop Compare
Бета
Порівнюйте два тексти, файли, PDF або зображення й бачте кожну зміну. Нічого не вивантажується.