Посібник з Slop OCR
Початок роботи зі Slop OCR
Slop OCR читає текст на зображеннях і в PDF. Модель розпізнавання працює у вашому браузері, тож ваші файли ніколи не вивантажуються.
Отримайте модель один раз
Уперше сторінка повідомляє: «Для цього інструмента потрібна модель». Це PP-OCRv4 (близько 15 МБ). Нічого не завантажується, доки ви самі не попросите.
- Натисніть «Отримати більше…».
- Прочитайте ліцензію і натисніть «Завантажити».
- Коли завантаження завершиться, з’явиться область для файлів. Модель лишається у вашому браузері для наступного разу.
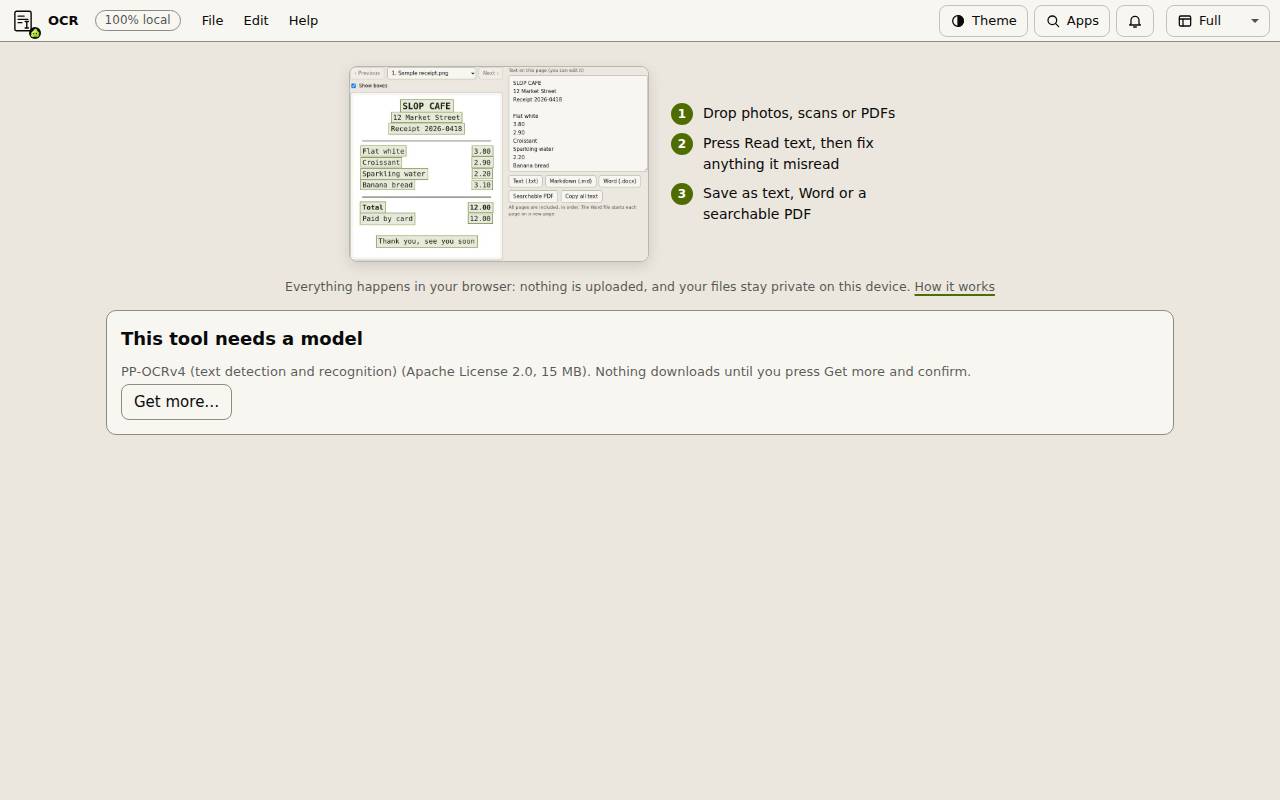
Прочитайте текст
- Перетягніть зображення або PDF у поле чи натисніть «Вибрати файли». Можна додати кілька одразу. Щоб спробувати, натисніть «Спробувати із зразковим чеком».
- Натисніть «Розпізнати текст». Смуга поступу показує, скільки вже зроблено.
- Кожну сторінку показано з рамками навколо знайдених рядків. Зніміть позначку «Показувати рамки», щоб їх сховати.
- Перемикайтеся між сторінками й файлами кнопками «Назад», «Далі» або списком сторінок.
Перевірте, виправте й збережіть
Текст сторінки, на якій ви є, — у полі праворуч. Його можна редагувати там перед збереженням.
Текст (.txt), Markdown (.md) і Word (.docx) зберігають усі сторінки в порядку; файл Word починає кожну сторінку з нової. «PDF з пошуком» зберігає зображення кожної сторінки і кладе зверху невидимий текст, тож його можна шукати й виділяти. «Копіювати весь текст» кладе його в буфер обміну.
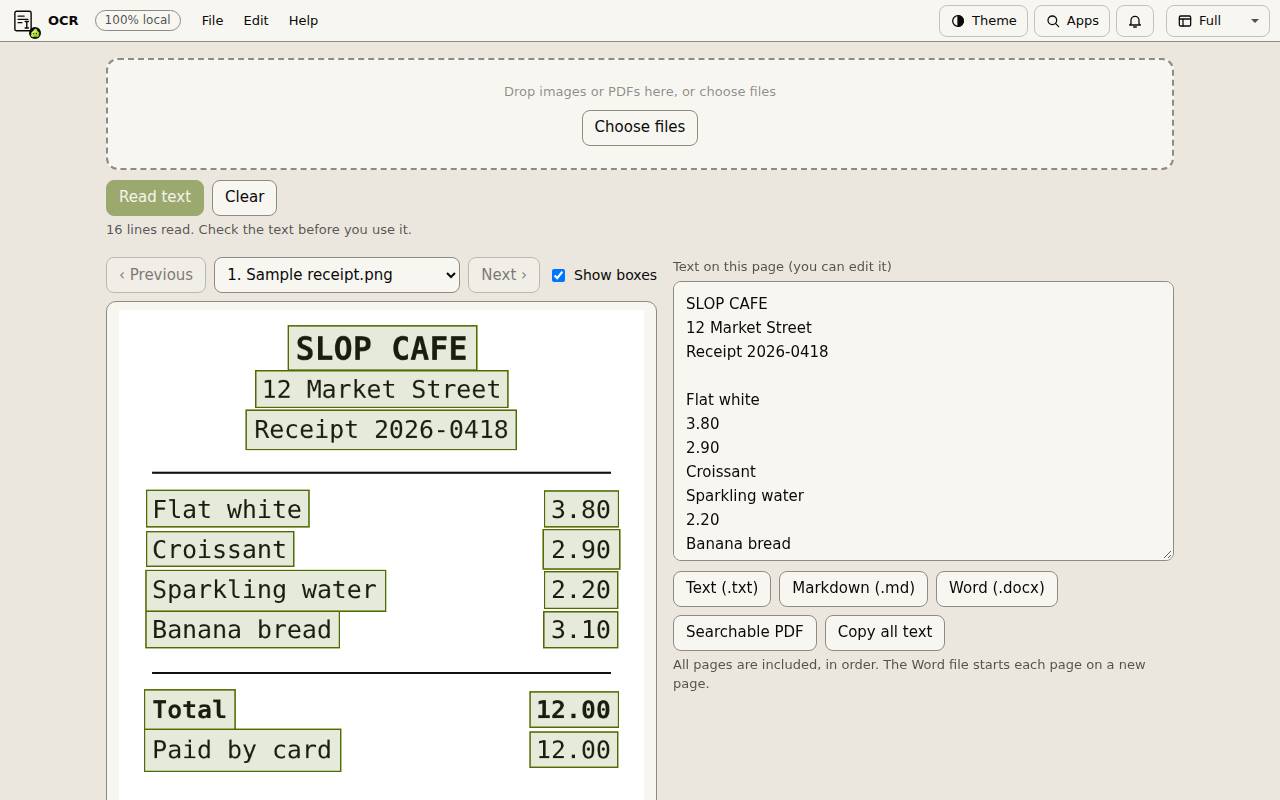
Порада: Перевірте текст, перш ніж його використовувати. Мову тексту виберіть у розділі «Мова і модель» (85 мов, одна модель на письмо); читаються лише горизонтальні рядки. Ціни праворуч від рядка можуть опинитися в окремих рядках.