Slop OCR · 無料、ブラウザーで
スキャンした PDF を検索可能な PDF に変換する
スキャンはページの画像にすぎないため、検索もコピーもできません。Slop OCR は各ページを読み取り、各画像の下に文字を隠した PDF を保存します。
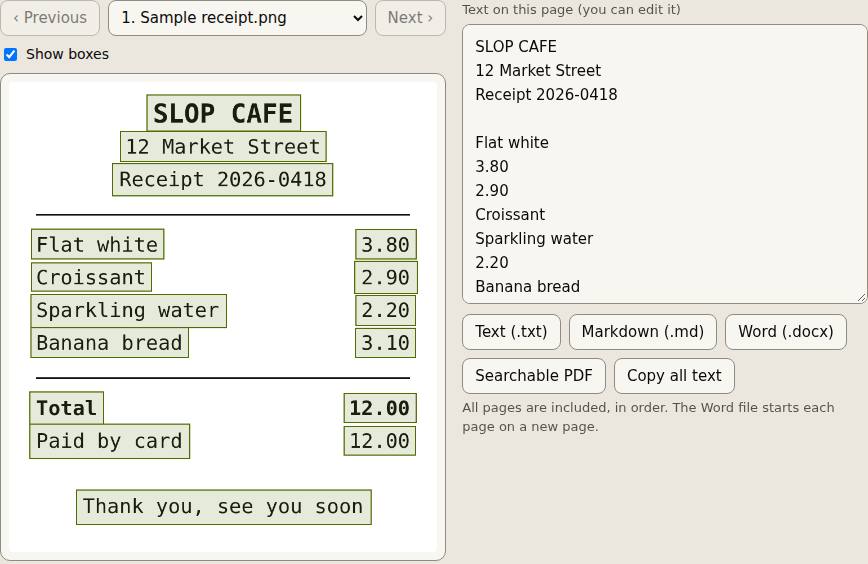
手順
- スキャンした PDF をページにドロップします。すべてのページが一覧に表示されます。
- 初回は「さらに入手」を選び、ライセンスに同意して OCR モデルをダウンロードします。
- 「文字を読み取る」を選び、各ページが 200 dpi で読み取られるまで待ちます。
- 「前へ」と「次へ」で各ページの文字を確認し、修正します。
- 「検索可能な PDF」を選び、新しいファイルをダウンロードします。
ファイルはこのデバイスに保存されたままです:Slop OCR はブラウザーで動作し、アップロードもアカウントも透かしも必要ありません。
よくある質問
PDF の見た目は変わりませんか?
変わりません。各ページの画像は残り、その上の目に見えない層に文字があるため、検索と選択で見つけられます。
文字の層にはどの文字が入りますか?
PDF の標準フォントで描けるのはラテン文字だけなので、英語のテキストが最も適しています。中国語など描けない文字は、層から除かれます。その場合も、画像にはその文字が表示されます。
代わりに Word ファイルで得られますか?
はい。「Word(.docx)として保存」を選ぶと、各ページが新しいページから始まる文字が得られます。プレーンテキストや Markdown としても保存できます。
スキャンはアップロードされますか?
いいえ。各ページは、お使いのデバイスに保存されたモデルで、ブラウザー内で読み取られます。
Slop OCR でほかにできること
関連するアプリ
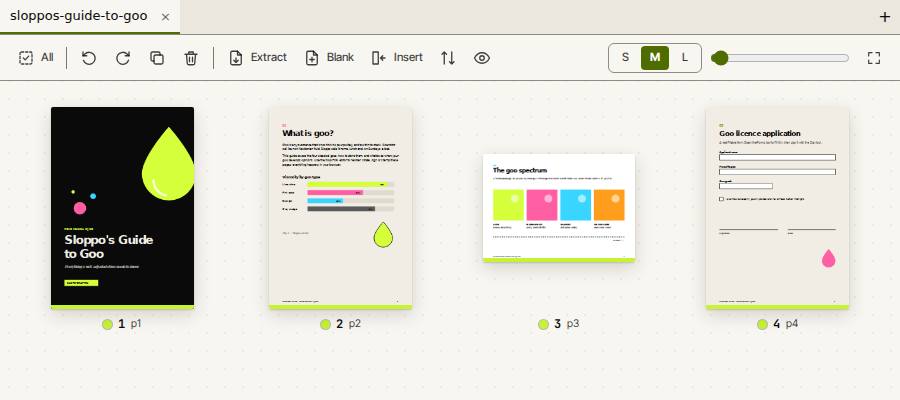 Slop PDF
公開中
PDFを整理、編集、署名できます。アップロードはありません。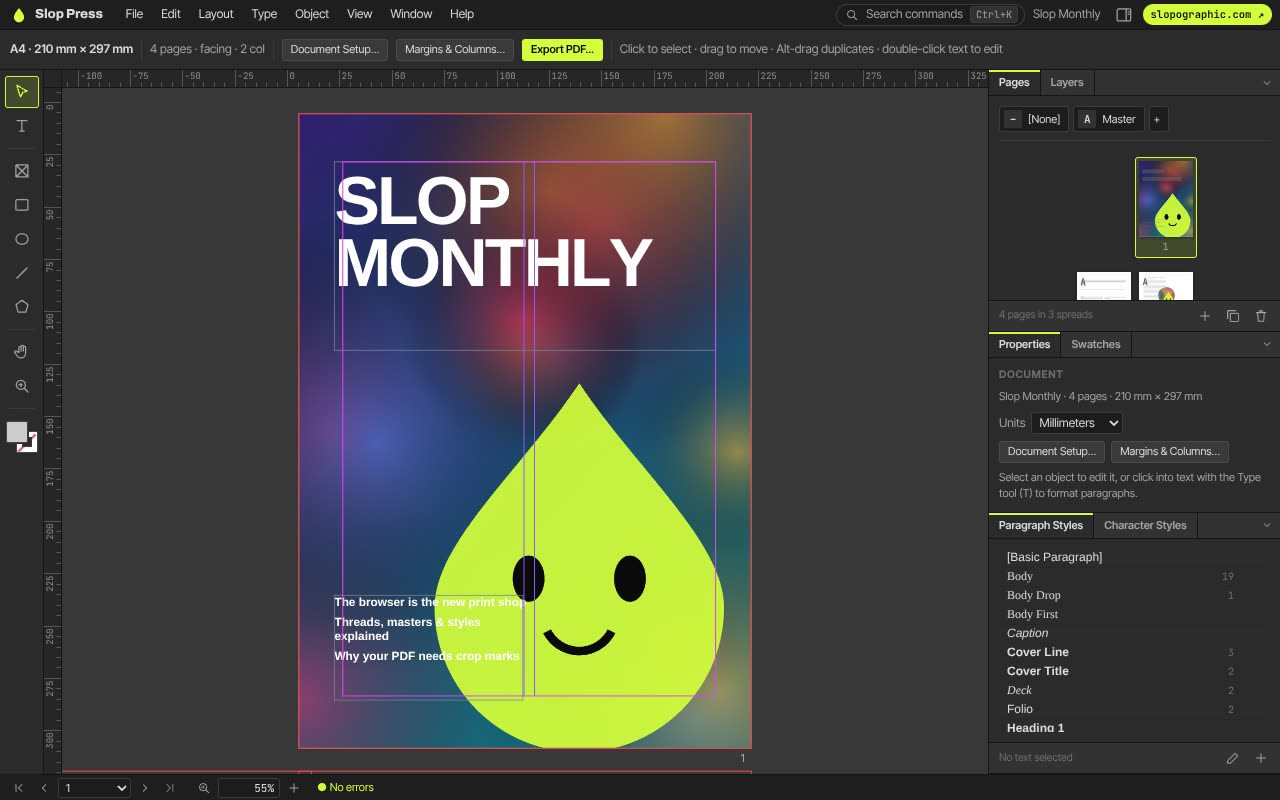 Slop Press
ベータ
InDesignを、ブラウザー向けに作り直しました。- Slop Compare
ベータ
2つのテキスト、ファイル、PDF、画像を比較し、すべての変更点を表示します。アップロードはありません。