Slop OCR ガイド
Slop OCRの使い方
Slop OCRは、画像とPDFの中の文字を読み取ります。読み取りのモデルはブラウザーの中で動くため、ファイルがアップロードされることはありません。
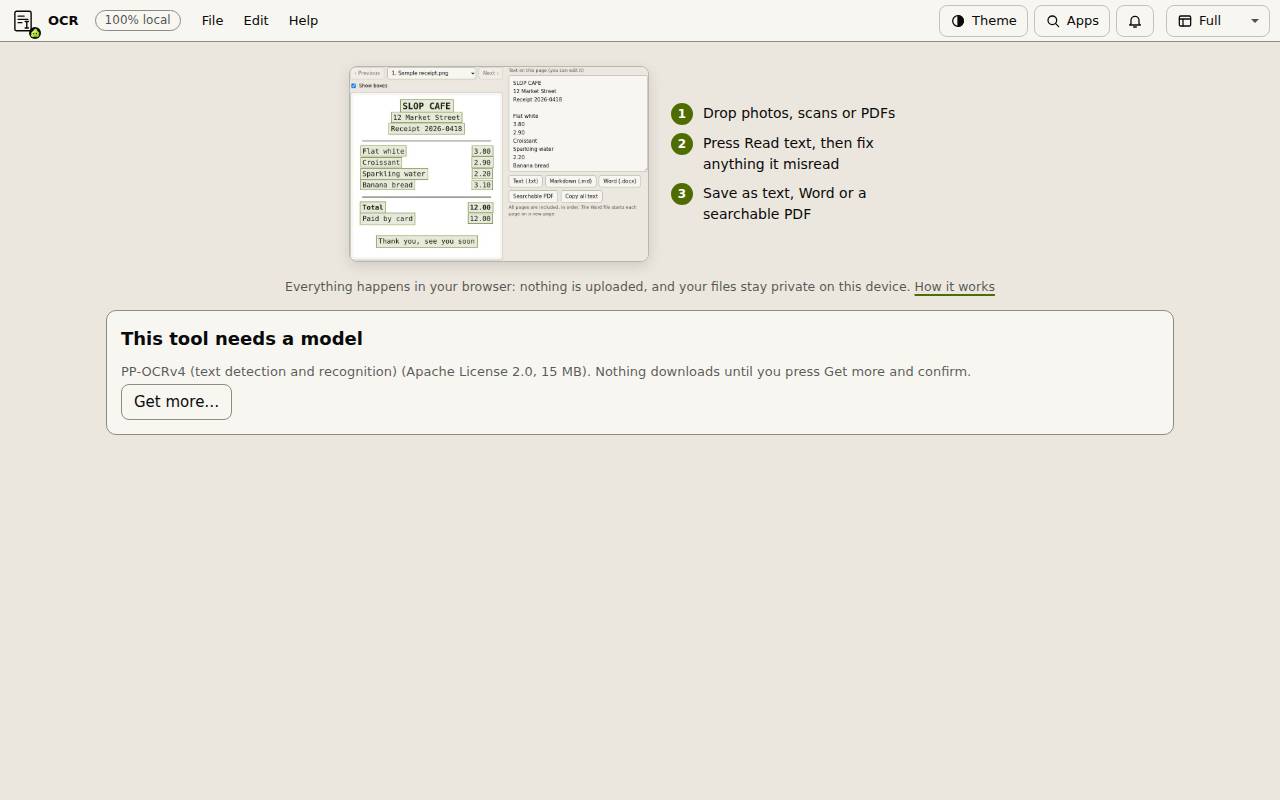
モデルを一度入手する
初めて使うとき、ページに「このツールにはモデルが必要です」と表示されます。モデルはPP-OCRv4(約15 MB)です。依頼するまで、何もダウンロードされません。
- 「もっと見る…」をクリックします。
- ライセンスを読んで、「ダウンロード」をクリックします。
- 完了すると、ファイルの領域が表示されます。モデルは次回のために、ブラウザーに保存されます。
文字を読み取る
- 画像またはPDFを枠にドロップするか、「ファイルを選択」をクリックします。一度に複数追加できます。試すには、「サンプルのレシートで試す」をクリックします。
- 「文字を読み取る」をクリックします。進行状況が進捗バーに表示されます。
- 各ページには、見つかった行の周りに枠が表示されます。枠を隠すには「枠を表示」のチェックを外してください。
- 「前へ」「次へ」またはページの一覧で、ページとファイルを移動します。
確認、修正、保存する
今表示しているページの文字は、右側の枠にあります。保存する前に、そこで編集できます。
テキスト(.txt)、Markdown(.md)、Word(.docx)は、すべてのページを順番どおりに保存します。Wordのファイルでは、各ページが新しいページから始まります。検索できるPDFは、各ページの画像を保ち、その上に見えない文字を重ねるため、検索や選択ができます。「すべての文字をコピー」を選ぶと、クリップボードに入ります。
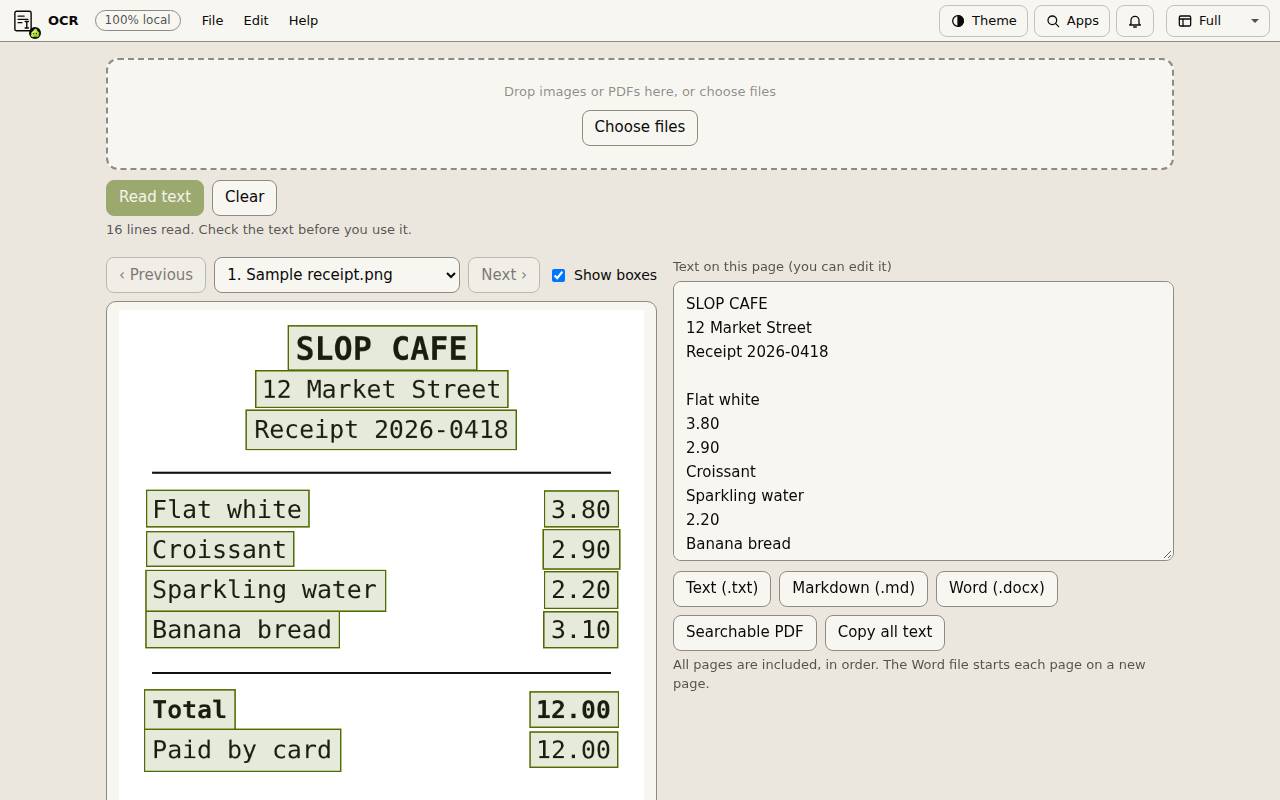
ヒント: 使う前に、文字を読み取り結果で確認してください。「言語とモデル」で文字の言語を選んでください(85言語、文字体系ごとに1つのモデル)。読み取られるのは横書きの行だけです。行の右側にある価格は、別の行として読まれる場合があります。