Slop OCR · бесплатно, в вашем браузере
Превращение скана PDF в PDF с поиском
Скан — это просто картинки страниц, поэтому по нему нельзя искать и копировать. Slop OCR читает каждую страницу и сохраняет PDF с текстом, скрытым под каждой картинкой.
Сделать PDF доступным для поиска
Как это сделать
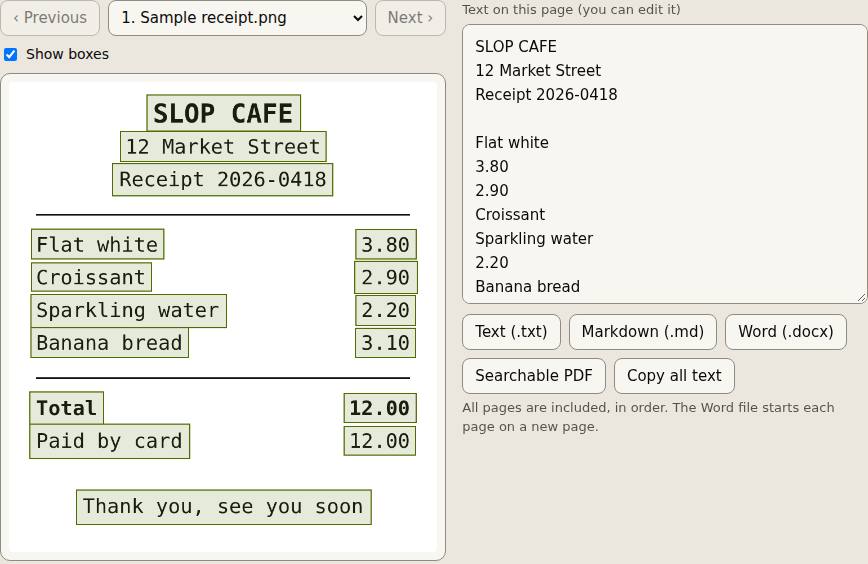
- Перетащите скан PDF на страницу. Каждая страница появится в списке.
- В первый раз выберите «Получить больше…» и примите лицензию, чтобы загрузить модель OCR.
- Выберите «Распознать текст» и дождитесь, пока каждая страница будет прочитана с разрешением 200 dpi.
- Проверьте и исправьте текст каждой страницы кнопками «‹ Назад» и «Далее ›».
- Выберите «PDF с поиском», чтобы скачать новый файл.
Ваши файлы остаются на этом устройстве: Slop OCR работает в браузере, без отправки, без учётной записи и без водяных знаков.
Вопросы
PDF выглядит так же?
Да. Картинка каждой страницы сохраняется, а текст лежит в невидимом слое поверх неё, где его находят поиск и выделение.
Какие символы попадают в текстовый слой?
Стандартный шрифт PDF рисует только латинские буквы, поэтому лучше всего работает английский текст. Символы, которые он не может нарисовать, например китайские, в слой не попадают; картинка их по-прежнему показывает.
Можно ли получить файл Word?
Да. Сохраните как Word (.docx), чтобы получить текст, где каждая страница начинается с новой, или как простой текст или Markdown.
Скан загружается?
Нет. Каждая страница читается в вашем браузере моделью, которая хранится на вашем устройстве.
Другие задачи в Slop OCR
Похожие приложения
 Slop PDF
Работает
Упорядочивайте, редактируйте и подписывайте PDF. Ничего не отправляется. Slop Press
Бета
InDesign, переделанный для браузера.- Slop Compare
Бета
Сравните два текста, файла, PDF или изображения и увидьте каждое изменение. Ничего не отправляется.