Руководство по Slop OCR
Начало работы со Slop OCR
Slop OCR читает текст на изображениях и в PDF. Модель распознавания работает в вашем браузере, поэтому ваши файлы никогда не отправляются.
Получите модель один раз
При первом запуске страница сообщит, что инструменту нужна модель. Это PP-OCRv4 (около 15 МБ). Ничего не загружается, пока вы не попросите.
- Нажмите «Получить больше…».
- Прочитайте лицензию и нажмите «Скачать».
- Когда загрузка завершится, появится область для файлов. Модель останется в вашем браузере до следующего раза.
Читайте текст
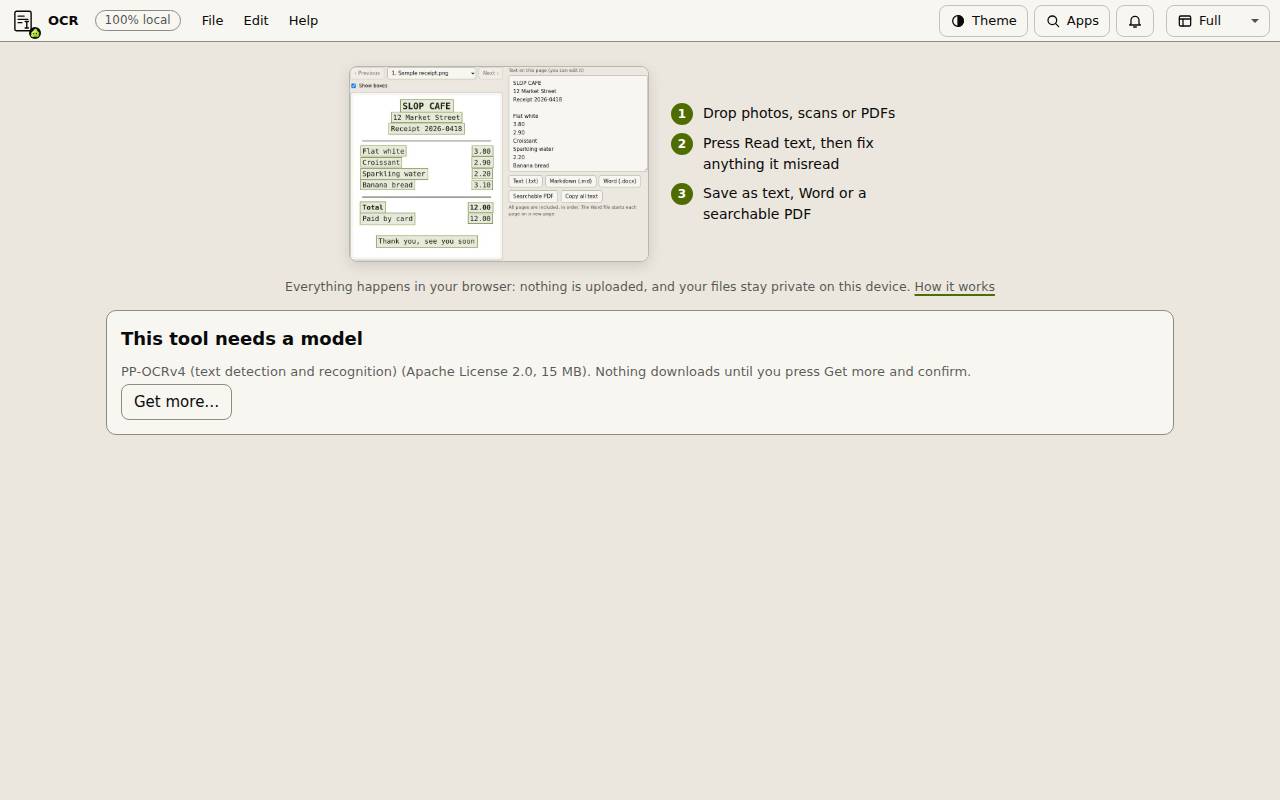
- Перетащите изображения или PDF в поле или нажмите «Выбрать файлы». Можно добавить сразу несколько. Чтобы попробовать, нажмите «Попробовать с примером чека».
- Нажмите «Читать текст». Полоса прогресса показывает, сколько уже готово.
- Каждая страница показана с рамками вокруг найденных строк. Снимите «Показывать рамки», чтобы их скрыть.
- Чтобы перейти между страницами и файлами, используйте «Назад», «Далее» или список страниц.
Проверьте, исправьте и сохраните
Текст страницы, на которой вы находитесь, показан в поле справа. Его можно исправить там перед сохранением.
Текст (.txt), Markdown (.md) и Word (.docx) сохраняют все страницы по порядку; в файле Word каждая страница начинается с новой. PDF с поиском сохраняет картинку каждой страницы и кладёт поверх невидимый текст, поэтому его можно искать и выделять. «Копировать весь текст» помещает его в буфер обмена.
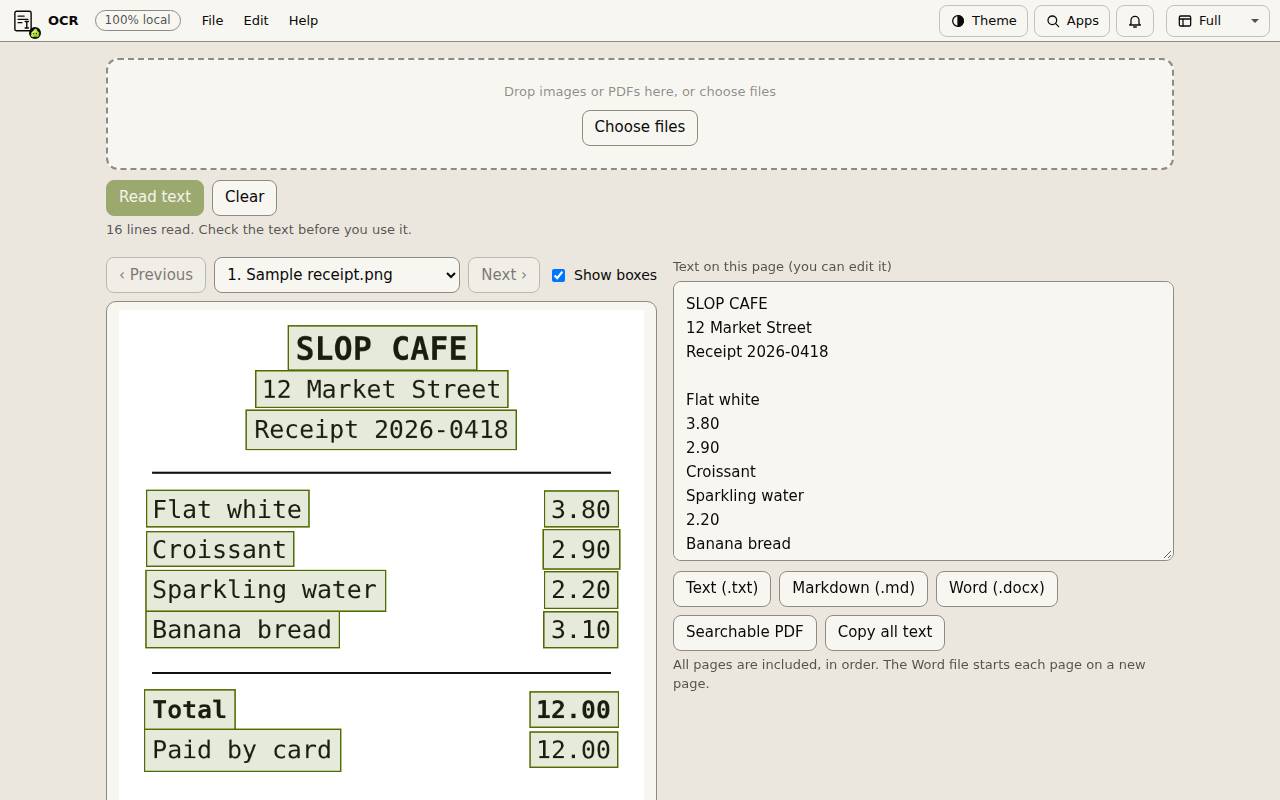
Совет: Проверяйте текст перед использованием. Язык текста выберите в разделе «Язык и модель» (85 языков, одна модель на письменность); читаются только горизонтальные строки. Цены справа от строки могут попасть на отдельные строки.