Przewodnik: Slop OCR
Pierwsze kroki w Slop OCR
Slop OCR odczytuje tekst na zdjęciach i w PDF-ach. Model rozpoznawania działa w przeglądarce, więc Twoje pliki nigdy nie są przesyłane.
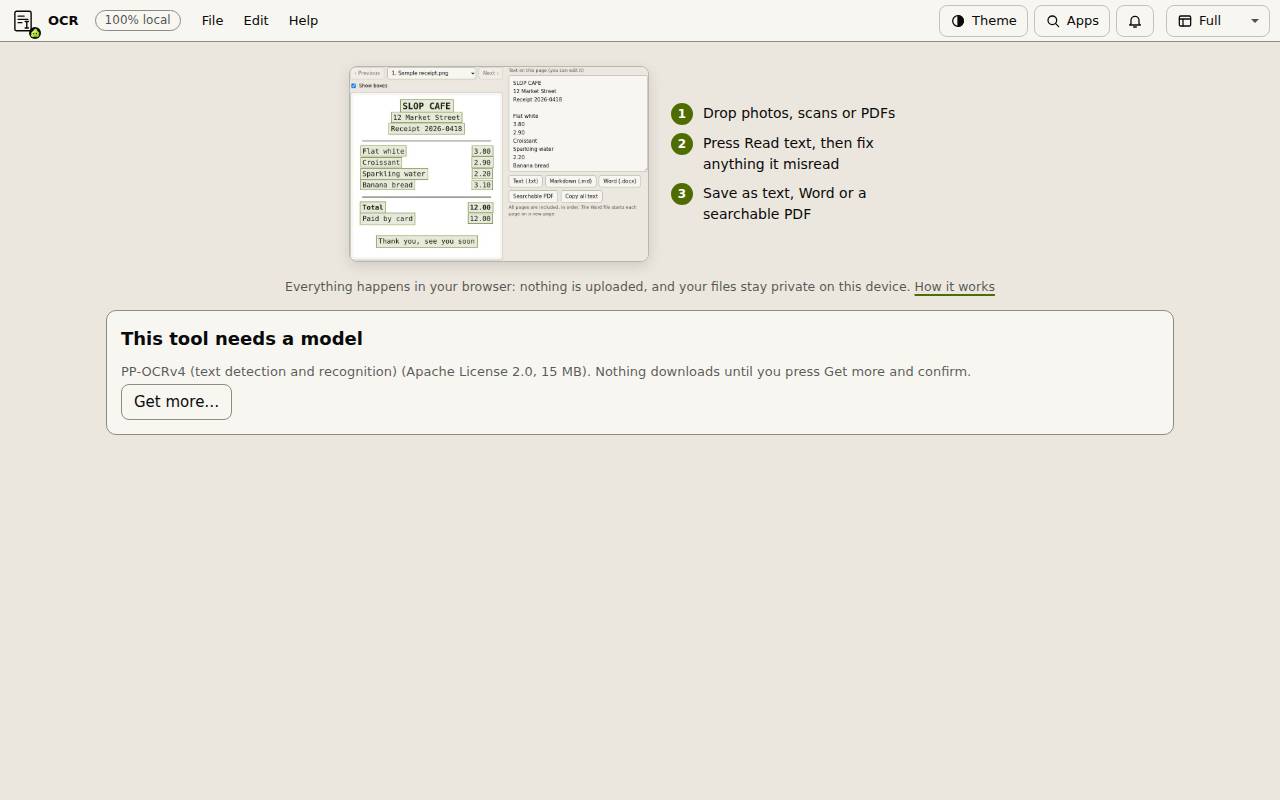
Pobierz model raz
Za pierwszym razem strona pisze: To narzędzie potrzebuje modelu. Modelem jest PP-OCRv4 (około 15 MB). Nic nie jest pobierane, dopóki o to nie poprosisz.
- Kliknij Pobierz więcej….
- Przeczytaj licencję i kliknij Pobierz.
- Gdy pobieranie się skończy, pojawi się obszar plików. Model zostaje w przeglądarce na następny raz.
Odczytaj tekst
- Upuść zdjęcia lub PDF-y w pole albo kliknij Wybierz pliki. Możesz dodać kilka naraz. Aby wypróbować, kliknij Wypróbuj z przykładowym paragonem.
- Kliknij Odczytaj tekst. Pasek postępu pokazuje, jak daleko doszło.
- Każda strona pokazuje się z ramkami wokół znalezionych wierszy. Odznacz Pokaż ramki, aby je ukryć.
- Użyj Poprzedni, Następny albo listy stron, aby przechodzić między stronami i plikami.
Sprawdź, popraw i zapisz
Tekst bieżącej strony jest w polu po prawej. Możesz go tam edytować, zanim go zapiszesz.
Tekst (.txt), Markdown (.md) i Word (.docx) zapisują wszystkie strony po kolei; plik Worda zaczyna każdą stronę na nowej stronie. PDF z możliwością przeszukiwania zachowuje obraz każdej strony i kładzie na wierzchu niewidoczny tekst, więc można go przeszukiwać i zaznaczać. Kopiuj cały tekst umieszcza go w schowku.
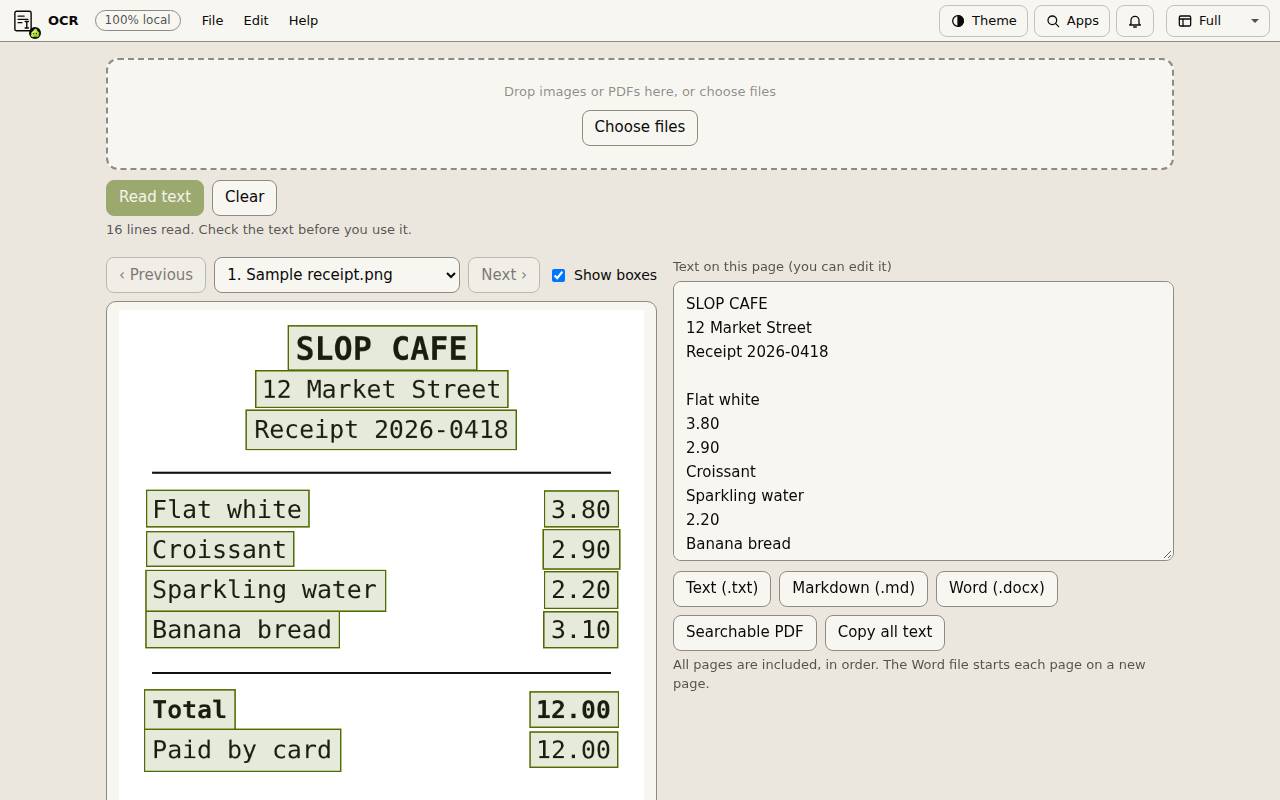
Wskazówka: Sprawdź tekst, zanim go użyjesz. Wybierz język tekstu w sekcji Język i model (85 języków, jeden model na pismo), a odczytywane są tylko linie poziome. Ceny z prawej strony wiersza mogą trafić do osobnych wierszy.