Slop OCR-gids
Aan de slag met Slop OCR
Slop OCR leest de tekst in afbeeldingen en pdf’s. Het leesmodel draait in je browser, dus je bestanden worden nooit geüpload.
Haal het model één keer op
De eerste keer zegt de pagina Deze tool heeft een model nodig. Het model is PP-OCRv4 (ongeveer 15 MB). Er wordt niets gedownload tot je erom vraagt.
- Klik op Meer ophalen….
- Lees de licentie en klik op Downloaden.
- Als het klaar is, verschijnt het bestandsgebied. Het model blijft in je browser voor de volgende keer.
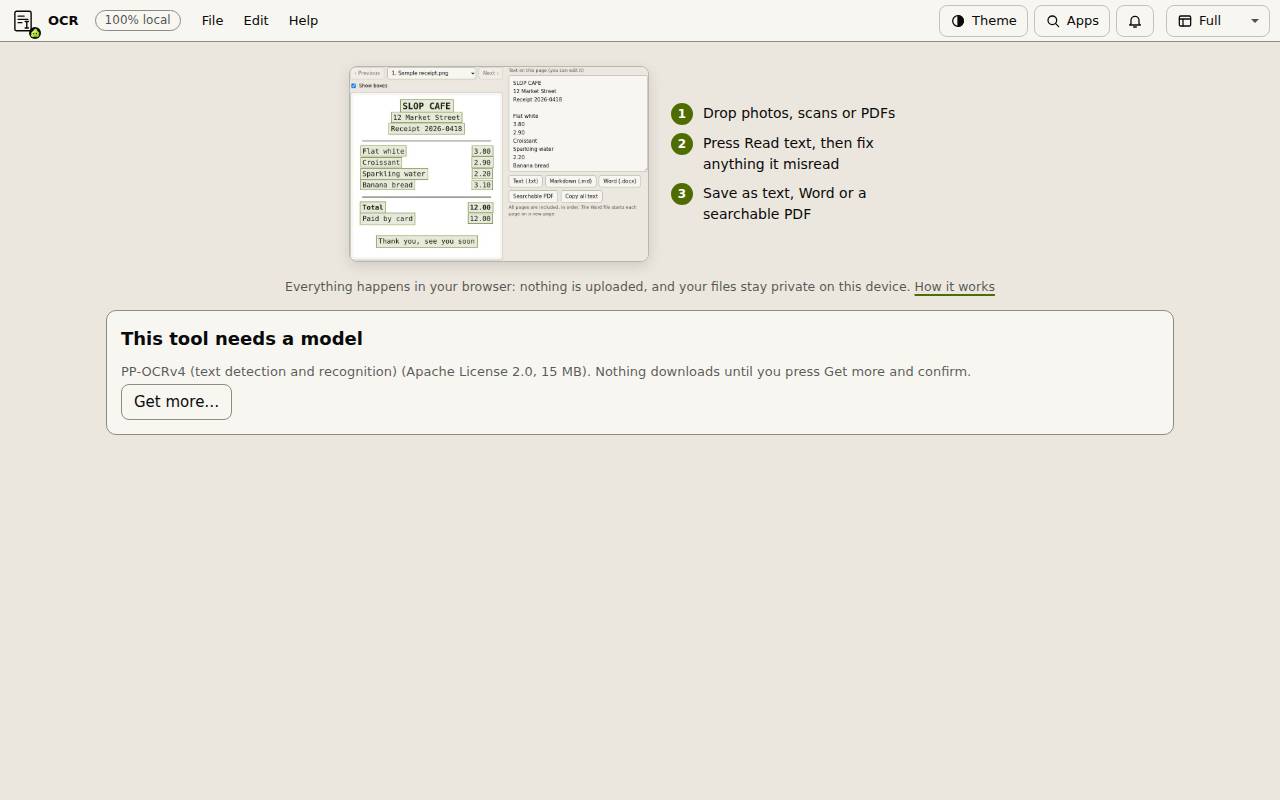
Lees de tekst
- Zet afbeeldingen of pdf’s in het vak neer, of klik op Bestanden kiezen. Je kunt er meerdere tegelijk toevoegen. Om het uit te proberen, klik je op Uitproberen met een voorbeeldbonnetje.
- Klik op Tekst lezen. Een voortgangsbalk toont hoe ver het is.
- Elke pagina toont kaders om de regels die het heeft gevonden. Haal het vinkje weg bij Kaders tonen om ze te verbergen.
- Gebruik Vorige, Volgende of de paginalijst om tussen pagina’s en bestanden te wisselen.
Controleer, corrigeer en sla op
De tekst van de pagina waar je op bent staat in het vak rechts. Je kunt hem daar bewerken voordat je opslaat.
Tekst (.txt), Markdown (.md) en Word (.docx) slaan alle pagina’s in volgorde op; het Word-bestand begint elke pagina op een nieuwe pagina. Doorzoekbare pdf bewaart de afbeelding van elke pagina en legt onzichtbare tekst eroverheen, zodat je erin kunt zoeken en selecteren. Alle tekst kopiëren zet hem op het klembord.
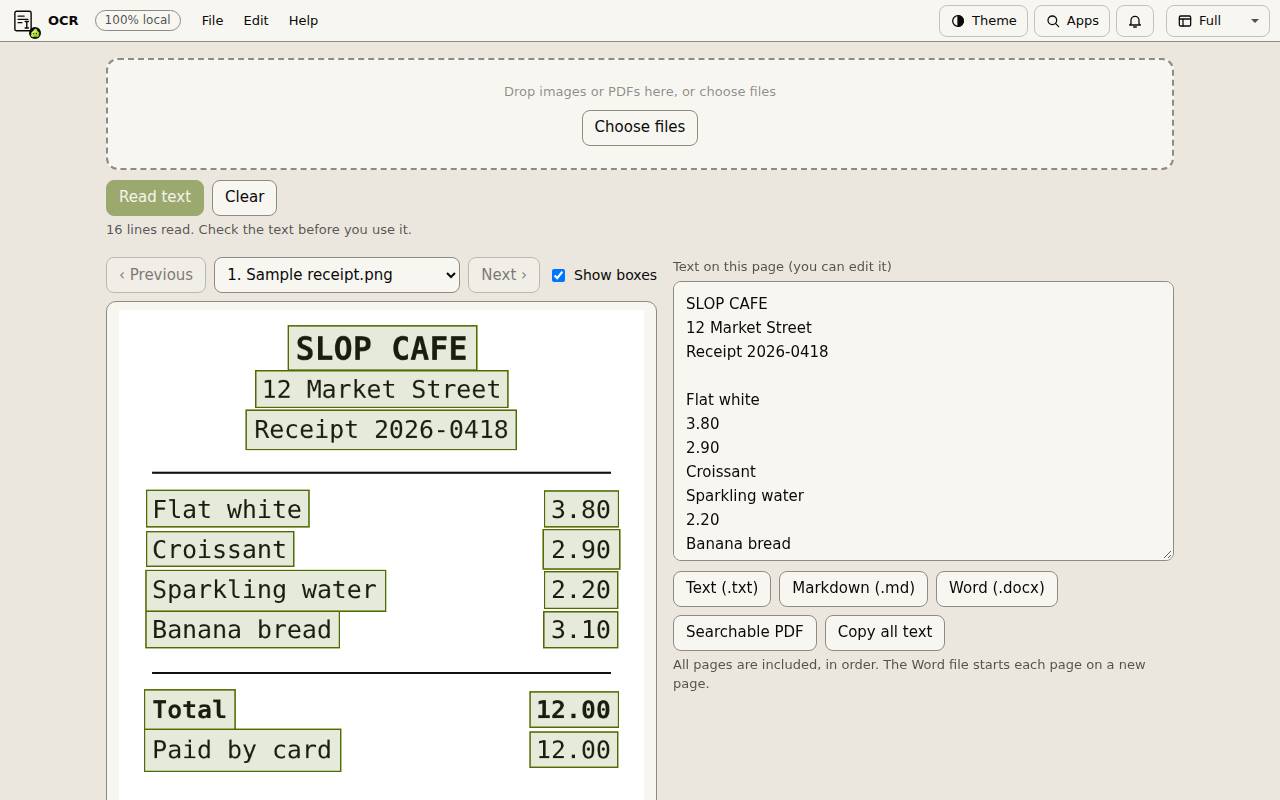
Tip: Lees de tekst na voordat je hem gebruikt. Kies de taal van de tekst onder Taal en model (85 talen, één model per schrift), en alleen horizontale regels worden gelezen. Prijzen rechts van een regel kunnen op hun eigen regels eindigen.