Slop OCR · 무료, 브라우저에서
스캔한 PDF를 검색 가능한 PDF로 바꾸기
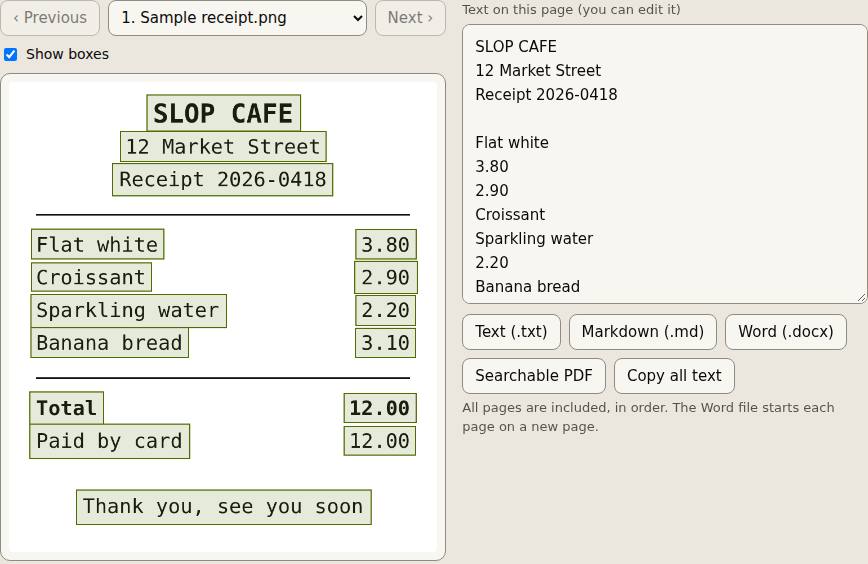
스캔은 페이지 그림일 뿐이라 검색하거나 복사할 수 없습니다. Slop OCR이 모든 페이지를 읽고, 각 그림 아래에 텍스트를 숨긴 PDF를 저장합니다.
하는 방법
- 스캔한 PDF를 페이지에 놓으세요. 모든 페이지가 나열됩니다.
- 처음이라면 더 받기를 고르고 라이선스에 동의해 OCR 모델을 내려받으세요.
- 텍스트 인식을 고르고, 각 페이지가 200 dpi로 읽히는 동안 기다리세요.
- 이전과 다음으로 각 페이지의 텍스트를 확인하고 고치세요.
- 검색 가능한 PDF를 고르면 새 파일을 내려받습니다.
파일은 이 기기에 그대로 남습니다. Slop OCR은(는) 브라우저에서 실행되며, 업로드, 계정, 워터마크가 없습니다.
질문
PDF가 여전히 같아 보이나요?
네. 각 페이지의 그림은 그대로 보관되고, 그 위에 보이지 않는 텍스트 층이 있어 검색과 선택이 그것을 찾습니다.
텍스트 층에는 어떤 문자가 들어가나요?
PDF의 표준 글꼴은 라틴 문자만 그리므로 영어 텍스트가 가장 잘 작동합니다. 중국어처럼 그릴 수 없는 문자는 층에서 빠지지만, 그림에는 여전히 보입니다.
대신 Word 파일을 받을 수 있나요?
네. Word(.docx)로 저장하면 각 페이지가 새 페이지에서 시작하는 텍스트를 얻고, 일반 텍스트나 Markdown으로도 저장할 수 있습니다.
스캔이 업로드되나요?
아니요. 모든 페이지는 기기에 저장된 모델로 브라우저에서 읽힙니다.
Slop OCR에서 더 많은 작업
관련 앱
 Slop PDF
공개
PDF를 정리하고, 편집하고, 서명하세요. 업로드되지 않습니다. Slop Press
베타
브라우저를 위해 다시 만든 InDesign.- Slop Compare
베타
두 텍스트, 파일, PDF, 사진을 비교하고 모든 변경 사항을 보세요. 업로드되지 않습니다.