Slop OCR 안내
Slop OCR 시작하기
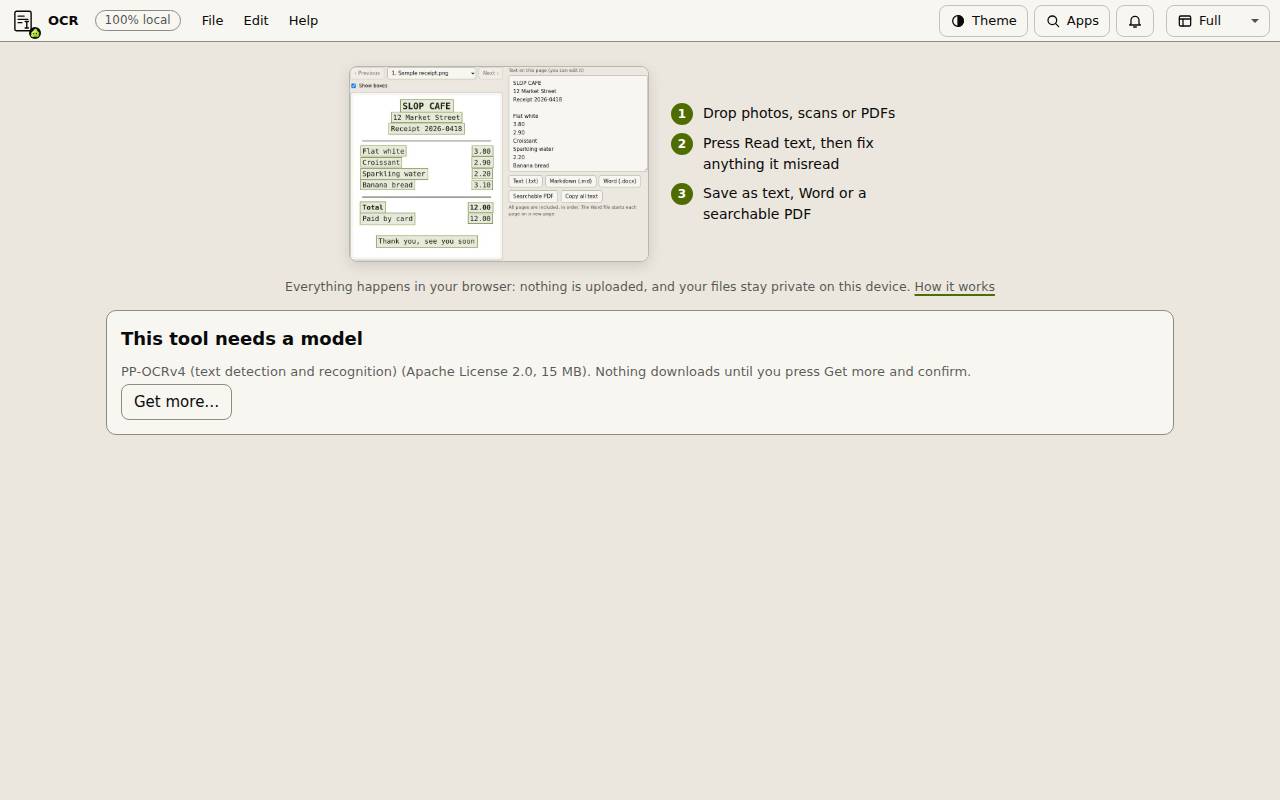
Slop OCR은 그림과 PDF의 텍스트를 읽습니다. 읽기 모델은 브라우저에서 실행되므로 파일은 절대 업로드되지 않습니다.
모델은 한 번만 받기
처음에는 페이지에 이 도구에는 모델이 필요합니다라고 나옵니다. 모델은 PP-OCRv4(약 15 MB)입니다. 요청하기 전에는 아무것도 내려받지 않습니다.
- 더 받기…를 클릭하세요.
- 라이선스를 읽고 다운로드를 클릭하세요.
- 다 받으면 파일 영역이 나타납니다. 모델은 다음번을 위해 브라우저에 남습니다.
텍스트 읽기
- 상자에 이미지나 PDF를 놓거나 파일 선택을 클릭하세요. 한꺼번에 여러 개를 추가할 수 있습니다. 해 보려면 샘플 영수증으로 해 보기를 클릭하세요.
- 텍스트 읽기를 클릭하세요. 진행 막대가 얼마나 진행되었는지 보여 줍니다.
- 페이지마다 찾은 줄 둘레에 상자가 표시됩니다. 상자 보이기를 해제하면 숨겨집니다.
- 이전, 다음 또는 페이지 목록으로 페이지와 파일 사이를 오가세요.
확인하고 고쳐서 저장하기
지금 보고 있는 페이지의 텍스트는 오른쪽 상자에 있습니다. 저장하기 전에 거기서 고칠 수 있습니다.
텍스트(.txt), Markdown(.md), Word(.docx)는 모든 페이지를 순서대로 저장합니다. Word 파일은 페이지마다 새 페이지로 시작합니다. 검색 가능한 PDF는 각 페이지의 그림을 유지하고 그 위에 보이지 않는 텍스트를 올려, 검색하고 선택할 수 있게 합니다. 모든 텍스트 복사는 클립보드에 넣습니다.
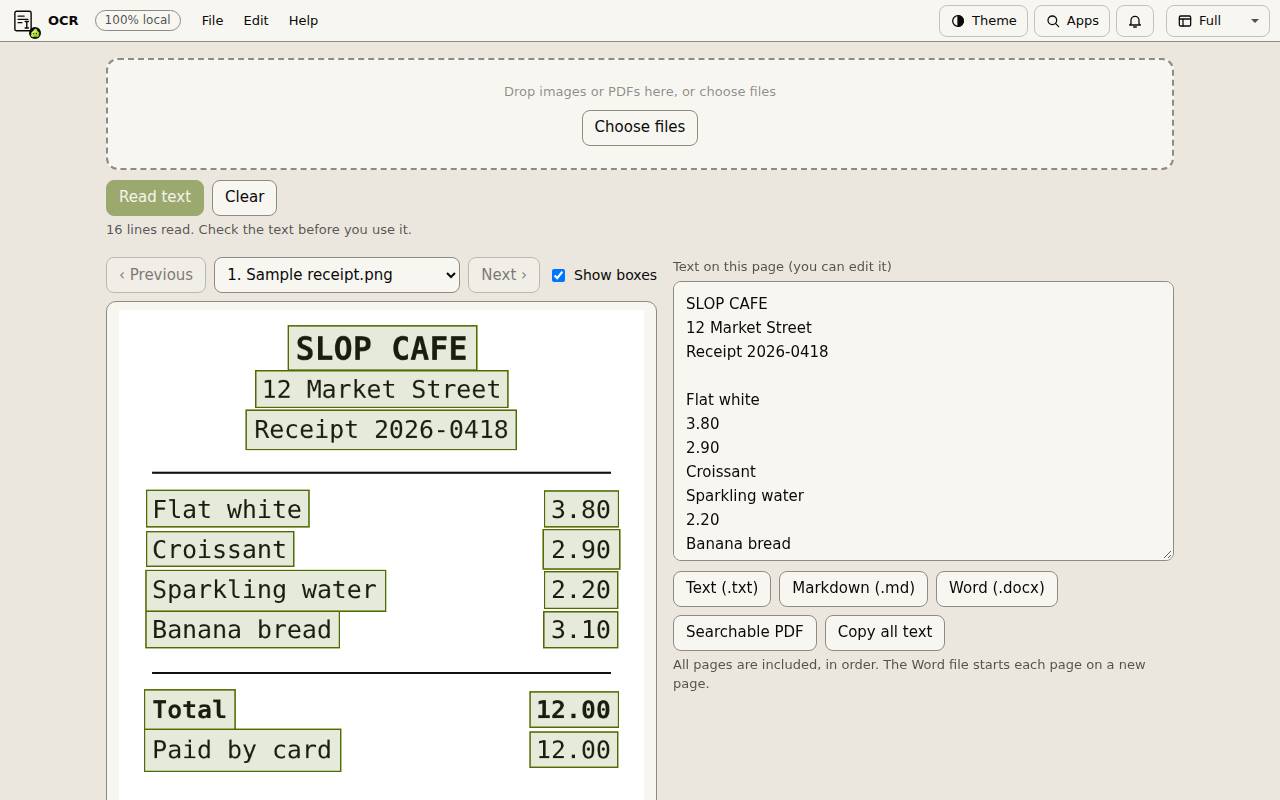
팁: 사용하기 전에 텍스트를 읽어 보세요. 언어와 모델 아래에서 텍스트의 언어(문자 체계마다 모델 하나로 85개 언어)를 고르세요. 가로줄만 읽히며, 줄의 오른쪽에 있는 가격은 따로 떨어져 나올 수 있습니다.